
· Par Équipe HeyData
Série : Les Technical Briefs d’Henric Cronström, relus pour Qlik Sense · article 1 sur 7
Jointures et lookups dans Qlik Sense : quand relier, quand joindre
Dans Qlik Sense, deux tables peuvent être reliées de deux façons : par une association dans le modèle de données, ou par une jointure dans le script. Le choix paraît technique. Il décide pourtant de la mémoire consommée, de la lisibilité du script et, surtout, de la justesse des Sum() et des Count().
Cet article synthétise et adapte à Qlik Sense le Technical Brief « Joins and Lookups » d’Henric Cronström (Qlik, septembre 2012). Ses documents techniques restent des références : nous les relisons avec les outils d’aujourd’hui.
Le problème
La plupart des outils de requête produisent une seule table dénormalisée : un SELECT peut lire plusieurs tables, mais il n’en rend qu’une. Le moteur de Qlik fonctionne autrement. Il garde plusieurs tables en mémoire et les relie par le nom des champs clés.
Le développeur venu du SQL a donc un réflexe : tout joindre dans le script. C’est parfois justifié. Souvent, c’est une source de lignes dupliquées et de totaux faux. Il faut donc savoir distinguer trois outils : l’association, la jointure et la fonction de lookup.
Association ou jointure : la différence
Une association est un lien entre deux tables qui partagent un champ de même nom. Ce n’est pas encore une jointure : elle n’est évaluée qu’au moment où l’utilisateur fait une sélection. Une jointure (préfixe Join) est exécutée pendant le chargement. Son résultat est une seule table dans le modèle.
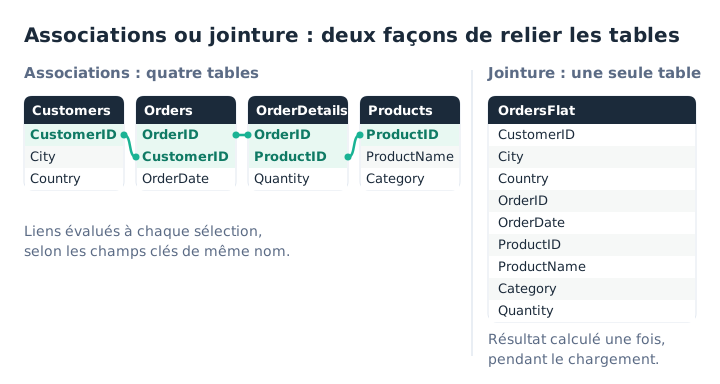
Associations évaluées à la sélection, ou table unique calculée au chargement.
Trois différences en découlent :
- Le moment : l’association est calculée à la demande, la jointure une fois pour toutes au rechargement.
- La nature : une jointure est explicitement interne, externe, gauche ou droite. Une association change selon le contexte. Sans sélection, elle se comporte comme une jointure externe complète. Si vous sélectionnez des clients, elle agit comme une jointure gauche : tous les clients sélectionnés restent possibles, même sans commande, mais seules leurs commandes le sont.
- La condition : une association est toujours une jointure naturelle, sur l’égalité des valeurs. Une condition comme
TableA.Key >= TableB.Keyest impossible.
Dans Qlik Sense, la visionneuse du modèle de données montre ces associations. Le Data Manager les propose aussi de façon visuelle. Le travail du développeur reste le même : nommer les clés à l’identique pour qu’elles se relient, et donner des noms uniques aux autres champs pour éviter les liens parasites.
Les jointures dans le script
Le danger : le nombre de lignes change
Joindre deux tables peut modifier le nombre de lignes. C’est souvent voulu. En joignant des en-têtes de commande à leurs lignes (relation 1:N), on obtient autant de lignes que dans la table de détail. Le prix à payer : un montant porté par l’en-tête, comme les frais de port, ne peut plus être sommé directement. Sur une relation N:N, le résultat peut dépasser la taille de chacune des tables d’origine.
Le vrai piège est la relation que l’on croit 1:1 alors qu’elle est 1:N. Des attributs produits stockés dans une table séparée en sont l’exemple type : un produit peut avoir plusieurs attributs.
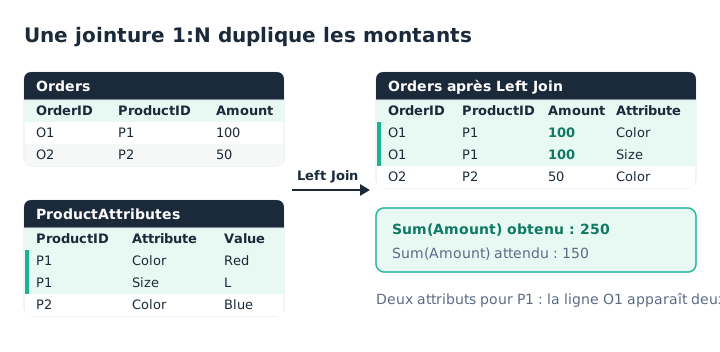
Un produit avec deux attributs, et la commande O1 compte double.
Le moteur ne se trompe pas : il additionne bien ce qui est dans la table. C’est le modèle qui ne dit plus ce que l’on croit.
La jointure SQL, exécutée par la base
Une jointure écrite dans un SQL SELECT est envoyée telle quelle au connecteur. Qlik Sense n’interprète pas la requête : c’est la base de données qui l’exécute. La syntaxe dépend donc du SGBD. Cette option est souvent plus efficace sur de gros volumes. Elle accepte aussi des jointures non naturelles, avec des inégalités.
LIB CONNECT TO 'Sales_DB';

SalesPerCustomer:
SQL SELECT c.CustomerID, c.CustomerName, SUM(s.SaleAmount) AS SalesAmount
FROM Customers c
LEFT JOIN Sales s ON c.CustomerID = s.CustomerID
GROUP BY c.CustomerID, c.CustomerName;
Le préfixe Join, exécuté par Qlik
Le préfixe Join combine la table en cours de chargement avec une table déjà chargée. La jointure est naturelle : elle se fait sur les champs de même nom. Sans champ commun, on obtient le produit cartésien des deux tables. Par défaut, la jointure est externe. Inner, Left et Right en changent le type.
Orders:
LOAD OrderID, CustomerID, OrderDate
FROM [lib://Data/Orders.qvd] (qvd);

Left Join (Orders)
LOAD CustomerID, CustomerName, Country
FROM [lib://Data/Customers.qvd] (qvd);
Cette jointure est rapide, mais gourmande en mémoire. Elle convient bien aux petites tables. Sur de grosses tables, la jointure dans la base est souvent préférable.
Le préfixe Keep, pour filtrer sans fusionner
Keep compare les tables comme une jointure, mais les laisse séparées. Il supprime seulement les lignes qu’une jointure aurait écartées. Il doit être précédé de Inner, Left ou Right. Cas classique : on ne charge qu’une partie des transactions, puis seulement les produits correspondants.
OrderDetails:
LOAD * FROM [lib://Data/OrderDetails.qvd] (qvd)
WHERE OrderDate >= MakeDate(2026, 1, 1);

Products:
Left Keep (OrderDetails)
LOAD * FROM [lib://Data/Products.qvd] (qvd);
Les fonctions de lookup
Beaucoup de jointures servent en réalité à traduire une valeur : obtenir la catégorie à partir de l’identifiant produit. Une seule valeur est attendue par clé. Pour ce besoin, l’auteur est net : évitez la jointure et utilisez une fonction de lookup. Le script est plus rapide et le nombre de lignes ne bouge pas. Si plusieurs valeurs sont attendues par clé, la fonction de lookup n’est pas le bon outil : elle ne renvoie que la première trouvée.
ApplyMap(), le choix par défaut
ApplyMap() s’appuie sur une table de mapping de deux colonnes : la valeur source, puis la valeur cible. Les noms des colonnes n’ont pas d’importance. La table de mapping est supprimée automatiquement à la fin du script. Le troisième paramètre, recommandé, fixe la valeur renvoyée quand la clé est absente.
Map_Category:
Mapping LOAD ProductID, Category
FROM [lib://Data/Products.qvd] (qvd);

OrderData:
LOAD *,
    ApplyMap('Map_Category', ProductID, 'Missing') AS Category
FROM [lib://Data/OrderData.qvd] (qvd);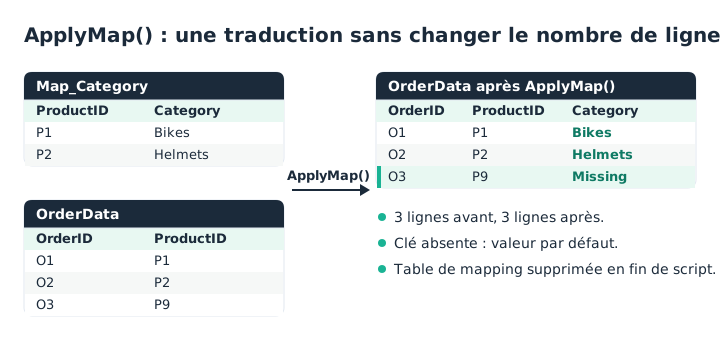
ApplyMap() ajoute un champ sans ajouter de ligne.
Son seul inconvénient : il faut préparer la table de mapping avant de l’utiliser.
Lookup(), plus souple mais plus lent
Lookup() lit un champ dans n’importe quelle table déjà chargée. Les noms de champs et de table sont passés entre apostrophes. La valeur cherchée, issue de la table en cours, ne l’est pas.
OrderData:
LOAD *,
    Lookup('Category', 'ProductID', ProductID, 'Products') AS Category
FROM [lib://Data/OrderData.qvd] (qvd);
Elle est flexible, mais nettement plus lente qu’ApplyMap().
Exists() et Peek(), deux cas particuliers
Exists() ne renvoie pas de valeur. Il indique si une valeur a déjà été chargée dans un champ. Il sert à exclure des lignes, ou à réduire une table maître aux clés déjà présentes, comme Keep.
Discontinued:
LOAD ProductID AS DiscontinuedID
FROM [lib://Data/DiscontinuedProducts.qvd] (qvd);

Products:
LOAD * FROM [lib://Data/Products.qvd] (qvd)
WHERE NOT Exists(DiscontinuedID, ProductID);
Peek() lit une valeur par numéro de ligne : Peek('Category', -1, 'Products') renvoie la dernière. Comme on connaît rarement le numéro de ligne utile, son usage comme lookup reste limité.
Normaliser ou dénormaliser ?
L’auteur penche pour un modèle aussi normalisé que possible. Ses arguments :
- il consomme le moins de mémoire ;
- les calculs y sont en général aussi rapides, parfois plus ;
- un script avec peu de transformations se lit et se maintient mieux ;
- le nombre de lignes ne change pas, donc
Sum()etCount()restent justes.
Ce dernier point compte d’autant plus dans Qlik Sense que les utilisateurs créent eux-mêmes leurs visualisations. Ils n’ont pas à connaître les subtilités du modèle.
Le cas n’est pourtant pas tranché. Une expression comme Sum(Price * Quantity), dont les champs sont dans deux tables, oblige le moteur à construire une jointure en mémoire au moment du calcul. Si ces tables sont éloignées dans le modèle, joindre dans le script peut améliorer les temps de réponse. Avec des tables de dimension modestes, l’écart reste en général marginal. Deux grosses tables liées, comme des en-têtes et des lignes de commande, gagnent souvent à être jointes. Les champs de l’en-tête ne se comptent alors plus qu’avec Count(DISTINCT …), plus lent sur une grande table.
La conclusion de l’auteur tient en une phrase : « The best join is often the one that never is made » (Henric Cronström). Souvent, mais pas toujours.
À retenir
- Associer par défaut. Le modèle relie les tables par le nom des clés. Ne joignez que pour une raison claire.
- Vérifier la cardinalité. Une relation crue 1:1 qui est en fait 1:N duplique les lignes et fausse les totaux.
- ApplyMap() pour traduire. Une valeur par clé, un champ ajouté, aucune ligne en plus, et un troisième paramètre pour les clés absentes.
- Keep ou Exists() pour filtrer. Ils réduisent une table sans la fusionner avec une autre.
- Joindre pour la performance, en connaissance de cause. Mesurez le gain, puis demandez-vous si le script reste lisible et les formules simples à écrire.
Essayer dans Qlik Sense
Ce script reprend les exemples de l’article avec les données des schémas, chargées en INLINE : il ne dépend d’aucun fichier ni d’aucune base. Collez-le dans l’éditeur de chargement de données d’une application vide, choisissez l’exemple avec la variable vExemple, puis rechargez.
// Jointures et lookups dans Qlik Sense : script d'essai
// D'après « Joins and Lookups », Technical Brief d'Henric Cronström (Qlik, 2012), adapté par HeyData.
// Collez-le dans l'éditeur de chargement de données d'une application vide, choisissez
// l'exemple, rechargez, puis ouvrez la visionneuse du modèle de données.
SET vExemple = 1;   // 1 à 7

IF $(vExemple) <= 2 THEN
    // Exemples 1 et 2 : quatre tables reliées par CustomerID, OrderID et ProductID (premier schéma)
    Customers:
    LOAD * INLINE [
    CustomerID, City, Country
    C1, Lyon, France
    C2, Berlin, Germany
    C3, Madrid, Spain
    ];

    Orders:
    LOAD * INLINE [
    OrderID, CustomerID, OrderDate
    1001, C1, 2026-01-05
    1002, C2, 2026-01-12
    1003, C1, 2026-02-03
    ];

    OrderDetails:
    LOAD * INLINE [
    OrderID, ProductID, Quantity
    1001, P1, 1
    1001, P2, 2
    1002, P2, 1
    1003, P1, 3
    ];

    Products:
    LOAD * INLINE [
    ProductID, ProductName, Category
    P1, Road bike, Bikes
    P2, Helmet, Helmets
    P3, Bell, Accessories
    ];

    IF $(vExemple) = 2 THEN
        // Exemple 2 : les mêmes tables jointes en une seule, OrdersFlat
        OrdersFlat:
        NoConcatenate
        LOAD * RESIDENT Customers;
        Left Join (OrdersFlat) LOAD * RESIDENT Orders;
        Left Join (OrdersFlat) LOAD * RESIDENT OrderDetails;
        Left Join (OrdersFlat) LOAD * RESIDENT Products;
        DROP TABLES Customers, Orders, OrderDetails, Products;
        // C3, sans commande, garde une ligne ; P3, jamais commandé, disparaît.
    END IF
END IF

IF $(vExemple) = 3 THEN
    // Exemple 3 : une jointure 1:N duplique les montants (deuxième schéma)
    Orders:
    LOAD * INLINE [
    OrderID, ProductID, Amount
    O1, P1, 100
    O2, P2, 50
    ];

    Left Join (Orders)
    LOAD * INLINE [
    ProductID, Attribute, Value
    P1, Color, Red
    P1, Size, L
    P2, Color, Blue
    ];
    // 3 lignes : Sum(Amount) renvoie 250 au lieu de 150.
END IF

IF $(vExemple) = 4 THEN
    // Exemple 4 : Left Keep réduit Products aux produits commandés depuis 2026
    OrderDetails:
    LOAD OrderID, ProductID, Date(Date#(OrderDate, 'YYYY-MM-DD')) AS OrderDate
    INLINE [
    OrderID, ProductID, OrderDate
    1000, P3, 2025-12-20
    1001, P1, 2026-01-05
    1002, P2, 2026-01-12
    ]
    WHERE Date#(OrderDate, 'YYYY-MM-DD') >= MakeDate(2026, 1, 1);

    Products:
    Left Keep (OrderDetails)
    LOAD * INLINE [
    ProductID, ProductName
    P1, Road bike
    P2, Helmet
    P3, Bell
    ];
    // Deux tables séparées ; Products ne contient plus que P1 et P2.
END IF

IF $(vExemple) = 5 THEN
    // Exemple 5 : ApplyMap traduit sans ajouter de ligne (troisième schéma)
    Map_Category:
    Mapping LOAD * INLINE [
    ProductID, Category
    P1, Bikes
    P2, Helmets
    ];

    OrderData:
    LOAD *,
        ApplyMap('Map_Category', ProductID, 'Missing') AS Category
    INLINE [
    OrderID, ProductID
    O1, P1
    O2, P2
    O3, P9
    ];
    // 3 lignes avant, 3 lignes après ; O3 reçoit 'Missing'.
END IF

IF $(vExemple) = 6 THEN
    // Exemple 6 : Lookup lit une table déjà chargée
    Products:
    LOAD * INLINE [
    ProductID, Category
    P1, Bikes
    P2, Helmets
    ];

    OrderData:
    LOAD *,
        Lookup('Category', 'ProductID', ProductID, 'Products') AS OrderCategory
    INLINE [
    OrderID, ProductID
    O1, P1
    O2, P2
    O3, P9
    ];
    // O3 n'a pas de correspondance : OrderCategory est NULL.
END IF

IF $(vExemple) = 7 THEN
    // Exemple 7 : Exists écarte les produits arrêtés
    Discontinued:
    LOAD * INLINE [
    DiscontinuedID
    P3
    ];

    Products:
    LOAD * INLINE [
    ProductID, ProductName
    P1, Road bike
    P2, Helmet
    P3, Bell
    ]
    WHERE NOT Exists(DiscontinuedID, ProductID);

    DROP TABLE Discontinued;
    // Products ne contient que P1 et P2.
END IF
Source
« Joins and Lookups », QlikView Technical Brief, Henric Cronström (alias « hic » sur Qlik Community), septembre 2012, publié sur Qlik Community dans la rubrique QlikView Documents. Tout le mérite du contenu original lui revient ; l’adaptation à Qlik Sense et ses éventuelles erreurs sont de HeyData. Cet article fait partie de notre relecture des Technical Briefs : découvrir la série.