
· Par Stéphane Nouhaud
Le piège de la consommation mémoire de la table Qlik Sense & Qlik Cloud
« On voudrait juste une table avec toutes les lignes, pour pouvoir naviguer dedans. » La demande revient dans presque tous les projets Qlik. Elle paraît anodine : l’utilisateur ne regarde qu’une vingtaine de lignes à la fois. Pourtant, sur 10 millions de lignes, nous avons mesuré un pic de 3,9 Go de RAM pour une seule ouverture de la table. La raison tient au fonctionnement même du moteur, identique dans Qlik Sense Enterprise on Windows et dans Qlik Cloud : une table Qlik n’est pas une table de navigation. Cet article explique ce qui se passe, puis détaille deux parades : la solution classique, qui demande à l’utilisateur de filtrer, et une pagination manuelle pour les cas où l’on ne peut pas l’exiger.
Dans tout l’article, « table » désigne l’objet de visualisation Table de Qlik (Straight Table en anglais), posé sur une feuille, et non une table du modèle de données.
Une table Qlik n’est pas une grille de navigation
Une grille d’application de gestion ou un client SQL interroge la base page par page : LIMIT 100 OFFSET 200 ne lit que les lignes demandées. La table Qlik fonctionne autrement. Elle affiche le résultat d’un hypercube, et le moteur associatif le calcule en entier avant d’en montrer la moindre ligne :
- le moteur détermine toutes les combinaisons de dimensions possibles dans la sélection courante ;
- il calcule chaque mesure pour chacune de ces lignes, puis trie l’ensemble ;
- il garde le résultat dans son cache de résultats ;
- le client ne récupère que les lignes visibles, au fil du défilement ou des pages.
La pagination ou le défilement de la table n’agissent que sur l’étape 4. Ils allègent le réseau et le navigateur, pas le moteur : pour afficher 100 lignes sur 10 millions, le moteur en a calculé, trié et mis en cache 10 millions.
Le cache aggrave l’addition. Il est partagé entre les utilisateurs, ce qui est une bonne chose pour les tableaux de bord : un graphique déjà calculé pour un état de sélection est servi immédiatement au suivant. Mais chaque nouvel état de sélection crée une nouvelle entrée. Une table de détail consultée par vingt utilisateurs aux filtres différents, c’est vingt résultats de plusieurs centaines de mégaoctets chacun. Le moteur libère ce cache quand la mémoire se remplit, mais un pic de calcul à plusieurs gigaoctets peut, lui, saturer un serveur Qlik Sense. Dans Qlik Cloud, la mémoire disponible pour les applications est elle aussi limitée.
Limiter les dimensions de la table (afficher les 1 000 premières valeurs, par exemple) ne change rien : la limite réduit les lignes affichées, pas le calcul.
La solution classique : demander à l’utilisateur de filtrer
La parade la plus simple et la plus sûre consiste à ne pas calculer la table tant que le résultat est trop gros, et à dire à l’utilisateur comment le réduire. Les visualisations de Qlik Sense et de Qlik Cloud ont pour cela une propriété Condition de calcul, accompagnée d’un message affiché quand la condition n’est pas remplie.
Plafonner le nombre de lignes
On compte les lignes possibles avec GetPossibleCount() sur la clé de la table de faits. Cette fonction ne calcule rien d’autre que le nombre de valeurs possibles d’un champ : elle reste très rapide, même sur des millions de lignes.
// Condition de calcul de la table
GetPossibleCount(NumDossier) <= 50000

// Message affiché (expression)
='Affinez votre sélection : '
  & Num(GetPossibleCount(NumDossier), '# ##0')
  & ' lignes sélectionnées, 50 000 au maximum.'
Tant que la sélection contient plus de 50 000 dossiers, la table affiche le message et le moteur ne calcule pas son hypercube. Le message donne le nombre de lignes à faire baisser, ce qui guide l’utilisateur bien mieux qu’un simple « trop de données ».
Exiger certains filtres
On peut aussi exiger un filtre sur les champs qui ont un sens métier, par exemple une région ou un client, et combiner cette exigence avec le plafond :
// Condition de calcul : une région ou un client choisi, et pas plus de 50 000 lignes
(GetSelectedCount(Region) > 0 or GetSelectedCount(Client) > 0)
  and GetPossibleCount(NumDossier) <= 50000
Le message peut alors expliquer ce qui manque :
=If(GetSelectedCount(Region) = 0 and GetSelectedCount(Client) = 0,
    'Choisissez une région ou un client pour afficher le détail.',
    'Affinez votre sélection : '
      & Num(GetPossibleCount(NumDossier), '# ##0')
      & ' lignes sélectionnées, 50 000 au maximum.')
Ce qui rend la solution confortable
- Placer des volets de filtre sur les champs attendus à côté de la table, pour que l’utilisateur n’ait pas à les chercher.
- Afficher le nombre de lignes sélectionnées dans un KPI, coloré quand il dépasse le plafond.
- Fixer le plafond par la mesure : 50 000 lignes, c’est déjà bien plus que ce qu’un utilisateur lit ; le bon seuil dépend du nombre de colonnes et du serveur.
- Ne garder dans la table que les colonnes utiles : chaque colonne agrandit l’hypercube.
Cette solution couvre la plupart des besoins. Elle a une limite : tant que l’utilisateur n’a pas assez filtré, il ne voit rien. Quand le métier veut vraiment parcourir l’ensemble des lignes, il faut une autre approche.
Quand on ne peut pas imposer de filtre : la pagination manuelle
L’idée est de laisser l’utilisateur parcourir toutes les lignes, mais de ne faire calculer au moteur que la page affichée.
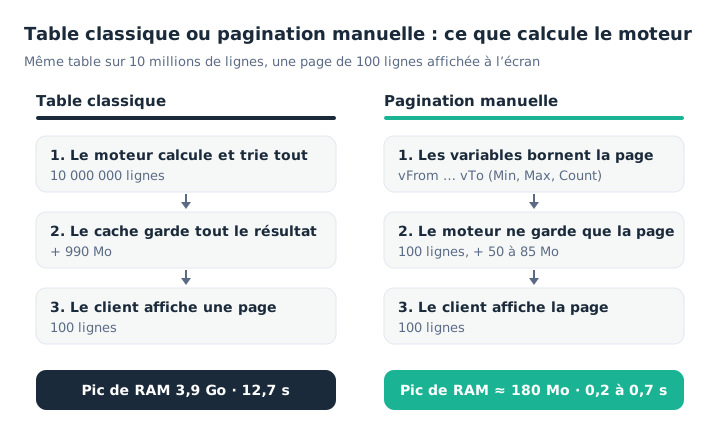
Le moteur ne garde que la page affichée au lieu de toute la table.
Une clé de ligne, calculée au chargement
Tout repose sur une clé RowID qui numérote les lignes dans l’ordre d’affichage voulu. Le tri se fait une fois pour toutes, au chargement :
Fait:
LOAD *, RowNo() as RowID
Resident FaitTmp
Order By DateOperation desc, NumDossier;

DROP Table FaitTmp;
Deux variables pour borner la page
Les variables calculent la plage de RowID de la page courante. Le = en tête fait évaluer chaque variable une seule fois par état de sélection, et non à chaque ligne. Dans le script, on écrit # à la place de $, puis on le remplace, pour que les $(…) ne soient pas développés au chargement :
SET vPageSize = 100;
SET vPage = 1;
LET vTaille  = Replace('=Ceil(#(vPageSize) * (Max(RowID) - Min(RowID) + 1) / Count(RowID))', '#', '$');
LET vNbPages = Replace('=Ceil((Max(RowID) - Min(RowID) + 1) / #(vTaille))', '#', '$');
LET vPageEff = Replace('=RangeMax(1, RangeMin(#(vPage), #(vNbPages)))', '#', '$');
LET vFrom    = Replace('=Min(RowID) + (#(vPageEff) - 1) * #(vTaille)', '#', '$');
LET vTo      = Replace('=#(vFrom) + #(vTaille) - 1', '#', '$');
Chaque page est une tranche de RowID dont la largeur vise vPageSize lignes en moyenne parmi les lignes possibles. Sans sélection, la tranche fait exactement 100 lignes. Avec une sélection, elle en contient environ 100 : nous avons observé entre 97 et 120 lignes.
vPageEff ramène la page demandée dans les bornes. Qlik Sense n’a pas de déclencheur « sur changement de sélection » : sans cette variable, un utilisateur en page 40 qui filtre jusqu’à n’avoir plus que 3 pages verrait une table vide. Avec elle, la table se cale sur la dernière page.
Filtrer la table sur la page
La table garde ses dimensions habituelles, précédées de RowID. Le filtre se place dans les mesures :
Sum({<RowID = {">=$(vFrom)<=$(vTo)"}>} Montant)Avec la suppression des valeurs nulles et des zéros (le réglage par défaut des tables), seules les lignes de la page restent dans l’hypercube.
Une variante filtre par la dimension plutôt que par les mesures. On remplace RowID par la dimension calculée suivante, en décochant Inclure les valeurs nulles :
=If(RowID >= $(vFrom) and RowID <= $(vTo), RowID)Sans ce réglage, les lignes hors de la page restent dans la table avec un numéro vide. Les deux variantes donnent des performances voisines (voir les mesures plus bas).
Les boutons de navigation
Quatre boutons, avec l’action Définir la valeur de la variable sur vPage, suffisent à naviguer :
| Bouton | Valeur |
|---|---|
| Première | 1 |
| Précédent | =RangeMax(1, $(vPageEff) - 1) |
| Suivant | =RangeMin($(vNbPages), $(vPageEff) + 1) |
| Dernière | =$(vNbPages) |
vPage est une variable de session : chaque utilisateur navigue sans gêner les autres. Un texte du type ='Page ' & $(vPageEff) & ' / ' & $(vNbPages) indique où l’on se trouve.
Le piège : calculer les pages par rang
Notre première version calculait des pages exactes par rang : Min(RowID, (vPage - 1) * 100 + 1) donne le premier RowID de la page. Sans sélection, c’est rapide. Mais avec une sélection et un rang élevé, Min(champ, rang) est devenu très coûteux : la dernière page d’une sélection de 167 000 lignes a demandé entre 71 et 140 secondes de calcul moteur, et jusqu’à 35 minutes lors d’un passage. C’est plus cher que la table complète.
La version par tranches n’utilise que Min, Max et Count, qui restent rapides quelle que soit la sélection. Elle accepte en échange des pages de taille approximative.
Les limites de la pagination manuelle
- Avec une sélection, les pages sont approximatives, et une page peut même être vide si la sélection est très concentrée sur une plage de
RowID. - Le tri est figé par
RowID: trier une colonne ne trie que la page courante. Pour proposer plusieurs ordres, on précalcule plusieurs clés (RowID_Date,RowID_Client…) et on choisit la clé avec une variable. - L’export ne contient que la page affichée.
Ce que ça change : les mesures
Nous avons mesuré l’application de test sur un serveur Qlik Sense Enterprise on Windows (4 cœurs, 24 Go de RAM), juste après un redémarrage du moteur, donc à cache vide. Le temps de calcul et le pic de RAM viennent du journal de performances du moteur (QixPerformance) ; la croissance du cache vient de son healthcheck.
| Ce qui est affiché | Lignes calculées | Temps moteur | Pic de RAM | Cache ajouté |
|---|---|---|---|---|
| Table complète, sans sélection | 10 000 000 | 12,7 s | 3 888 Mo | 990 Mo |
| Table complète, sélection de 166 220 lignes | 166 220 | 0,4 s | 219 Mo | 99 Mo |
| Page de 100 lignes (set analysis) | 100 | 0,2 à 0,3 s | 174 Mo | 85 Mo |
| Page de 100 lignes (dimension calculée) | 100 | 0,4 à 0,7 s | 191 Mo | 50 à 57 Mo |
Trois enseignements :
- une fois le résultat réduit à quelques centaines de milliers de lignes, la table classique redevient légère : c’est ce qui rend la condition de calcul si efficace ;
- la pagination manuelle divise le pic de RAM par 20 environ sur la table complète, sans demander de filtre ;
- le pic d’environ 180 Mo bouge très peu d’une page à l’autre : c’est vraisemblablement le coût du parcours des 10 millions de lignes, pas celui des lignes affichées.
Les temps varient avec la charge du serveur : la même table complète a demandé 136 secondes lors d’une mesure faite pendant que d’autres calculs tournaient.
Quelle solution choisir
| Situation | Solution |
|---|---|
| Le détail ne sert qu’après un filtre métier (client, dossier) | Condition de calcul avec filtres obligatoires |
| Le volume varie, l’utilisateur sait filtrer | Condition de calcul plafonnée, message qui guide |
| Le métier doit parcourir toutes les lignes | Pagination manuelle, avec une condition de calcul en garde-fou |
| Moins de quelques centaines de milliers de lignes | Table classique, sans précaution particulière |
Essayer dans Qlik Sense
L’application de test est disponible au téléchargement. Elle est livrée sans données : son script génère 10 millions de lignes aléatoires au rechargement (environ 40 secondes et 1 Go de RAM au pic sur notre serveur). Pour un essai plus léger, baissez vNbLignes en tête du script.
Télécharger l’application de test (.qvf, 180 Ko)
Elle contient trois feuilles : la pagination par set analysis, la variante par dimension calculée, et la table complète, à ouvrir en dernier car c’est elle qui mobilise 3,9 Go.
À retenir
- Une table Qlik n’est pas une grille de navigation. Le moteur calcule, trie et met en cache tout le résultat, quelle que soit la part affichée à l’écran.
- La pagination de la table ne protège pas le moteur. Elle ne fait que découper l’affichage d’un résultat déjà entièrement calculé.
- La condition de calcul est la première parade.
GetPossibleCount()plafonne le volume,GetSelectedCount()exige les bons filtres, et le message explique quoi faire. - La pagination manuelle prend le relais quand on ne peut pas filtrer. Une clé
RowID, deux variables évaluées une fois par sélection, un set analysis : le pic passe de 3,9 Go à 180 Mo.