
· Par Équipe HeyData
Série : Les Technical Briefs d’Henric Cronström, relus pour Qlik Sense · article 6 sur 7
Hiérarchies dans Qlik Sense : de la table parent-enfant aux droits d’accès
Une table parent-enfant décrit parfaitement un arbre, mais Qlik Sense ne sait pas l’exploiter telle quelle. Deux préfixes de script, Hierarchy et HierarchyBelongsTo, la transforment en champs utilisables. Avec eux, on obtient des niveaux pour les tableaux croisés, la sélection d’un sous-arbre entier et des droits d’accès par branche.
Cet article synthétise et adapte à Qlik Sense le Technical Brief « Hierarchies » d’Henric Cronström (Qlik, novembre 2013). Ses documents techniques restent des références : nous les relisons avec les outils d’aujourd’hui.
Le problème
Une hiérarchie est un ensemble de nœuds qui ont chacun un seul parent. Le calendrier, la gamme de produits, la géographie ou l’organigramme en sont des exemples. Les feuilles, elles, sont en général les transactions de la table de faits, rattachées chacune à un nœud.
Toutes les hiérarchies ne se ressemblent pas. Quatre questions permettent de les qualifier :
- Équilibrée ou non ? Dans une hiérarchie équilibrée, toutes les transactions pointent vers le même niveau. Le calendrier l’est en général : chaque commande a une date.
- Nombre de niveaux fixe ou variable ? Une hiérarchie peut garder un nombre fixe de niveaux et être déséquilibrée : un budget saisi au mois face à des ventes saisies au jour.
- Niveaux nommés ou non ? « Pays » ou « Ville » méritent leur propre champ. Les appellations viticoles, elles, n’ont pas de nom de niveau stable : un district peut être au troisième comme au cinquième rang.
- Irrégulière (ragged) ? Il manque un niveau sur certaines branches. Washington DC appartient aux États-Unis sans appartenir à aucun État.
Le cas simple, des niveaux nommés et fixes, se règle avec une dimension drill-down. Le cas difficile est la hiérarchie déséquilibrée à profondeur variable. Elle arrive presque toujours sous forme de table d’adjacence.
Comment la source stocke l’arbre
Les bases relationnelles ont plusieurs façons de ranger une hiérarchie. Il faut d’abord identifier la sienne :
- Horizontale : un champ par niveau (client, pays, région), parfois réparti sur plusieurs tables liées.
- Table d’adjacence : une ligne par nœud, avec une clé vers son parent. C’est le format le plus répandu, car déplacer une branche revient à modifier un seul
ParentID. - Énumération de chemins : chaque nœud stocke son chemin complet (
1/178/281). - Ensembles imbriqués : chaque nœud porte une borne basse et une borne haute qui englobent celles de ses descendants.
- Table des ancêtres : une ligne par couple ancêtre / descendant. Rare comme stockage, fréquente comme vue SQL.
Adjacence, chemins et ensembles imbriqués décrivent entièrement l’arbre, mais aucun n’est exploitable tel quel. Les préfixes Hierarchy et HierarchyBelongsTo partent de la table d’adjacence.
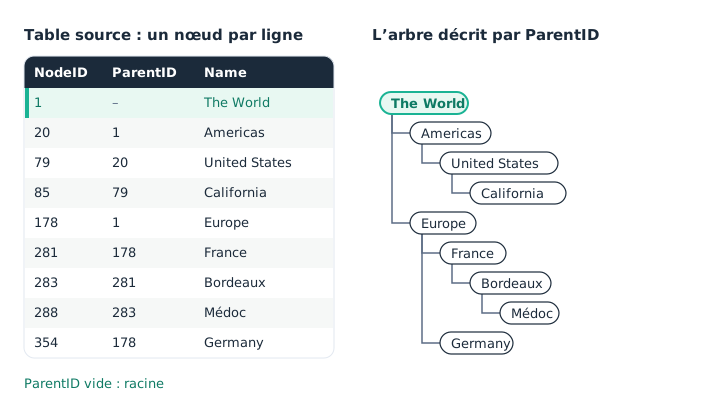
Une table d’adjacence : chaque ligne ne connaît que son parent.
Niveaux nommés : une dimension drill-down suffit
Si les niveaux ont un nom et que toutes les transactions pointent vers le même niveau, chargez la table telle quelle. Créez ensuite une dimension drill-down dans les éléments principaux (Année > Trimestre > Mois, par exemple). Elle remplace le groupe hiérarchique de QlikView et s’utilise dans tous les graphiques. Quand une seule valeur reste possible à un niveau, la visualisation descend au suivant.
Si les faits pointent vers des niveaux différents, comme le budget au mois et le réel au jour, la hiérarchie est déséquilibrée. Le Technical Brief renvoie alors aux clés génériques, traitées dans un autre article de la série.
Hierarchy : un champ par niveau
Le préfixe Hierarchy se place devant un LOAD qui lit la table d’adjacence. Il exige trois champs : l’identifiant du nœud, celui du parent et un nom. Un parent introuvable ou vide fait du nœud une racine. Si la source n’a pas de libellé, NodeID as Name fait l’affaire.
// Expanded nodes table: one row per node, one column per level
[Nodes]:
Hierarchy (NodeID, ParentID, Node, NodeParent, Node, NodePath, '/', NodeDepth)
LOAD
    NodeID,
    ParentID,
    NodeName as Node
FROM [lib://DataFiles/WineDistricts.qvd] (qvd);
Le résultat garde une ligne par nœud et ajoute Node1 à NodeN, un champ par niveau. Les paramètres optionnels ajoutent le nom du parent, le chemin (NodePath) et la profondeur (NodeDepth).
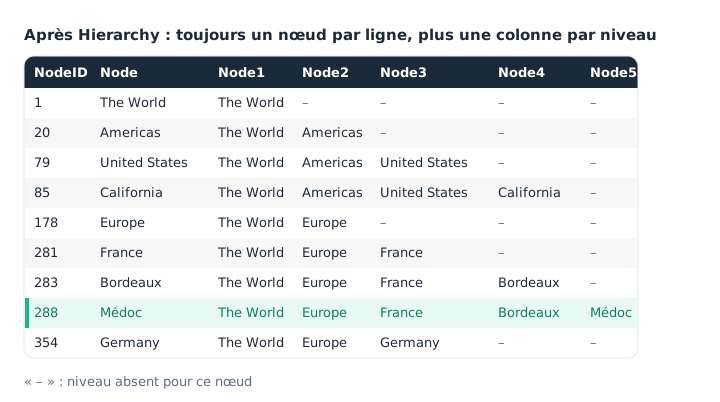
Après Hierarchy : la lignée de chaque nœud se lit de gauche à droite.
Dans Qlik Sense, Node1, Node2… servent de lignes à un tableau croisé dynamique. Les montants rattachés directement à un nœud intermédiaire apparaissent sur une ligne de niveau vide (« – ») sous ce nœud. Selon la version, l’option d’indentation des lignes rapproche l’affichage d’un arbre.
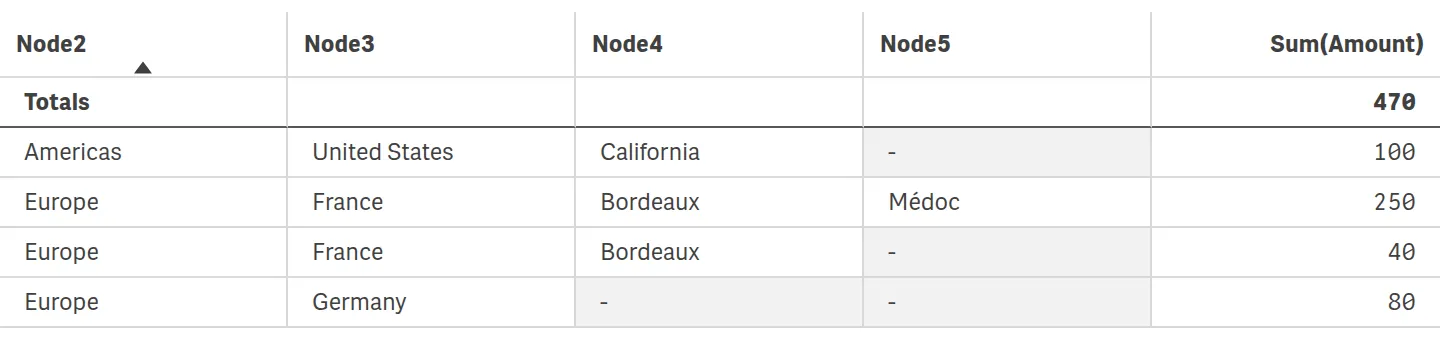
Dans Qlik Cloud : les 40 rattachés à Bordeaux, nœud intermédiaire, s’affichent sur une ligne dont le niveau suivant est vide.
QlikView affichait NodePath dans une list box en vue arborescente. Qlik Sense n’a pas d’équivalent natif dans le volet de filtres. Pour visualiser l’arbre, l’organigramme du Visualization bundle travaille à partir d’un couple identifiant / parent. Pour naviguer, nous utilisons plutôt une dimension drill-down sur les niveaux.
HierarchyBelongsTo : sélectionner un sous-arbre
La table des nœuds a une limite. Elle permet de sélectionner un nœud, mais pas « Europe et tout ce qu’elle contient ». C’est pourtant la sélection la plus naturelle. Le préfixe HierarchyBelongsTo répond à ce besoin.
// Ancestor table: one row per node / ancestor pair
[TreeBridge]:
HierarchyBelongsTo (NodeID, ParentID, NodeName, TreeID, TreeName)
LOAD
    NodeID,
    ParentID,
    NodeName
FROM [lib://DataFiles/WineDistricts.qvd] (qvd);
Il produit une table des ancêtres : chaque nœud y figure une fois par ancêtre, lui-même compris. Un sixième paramètre optionnel ajoute l’écart de profondeur entre le nœud et l’ancêtre.
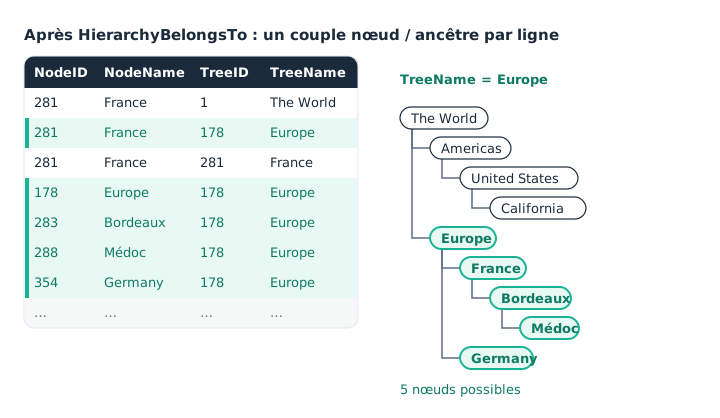
Sélectionner Europe dans TreeName rend possible toute la branche.
Le champ qui porte le nom du nœud doit s’appeler autrement que dans la table Nodes : NodeName ici, Node là-bas. Sinon, les deux tables partagent deux champs et Qlik crée une clé synthétique. La visionneuse du modèle de données permet de le vérifier après chargement.
On peut enfin charger une seconde fois la hiérarchie avec Hierarchy, cette fois sur les identifiants d’arbre. Ses champs Tree1 à TreeN alimentent une dimension drill-down qui navigue de sous-arbre en sous-arbre.
[Trees]:
Hierarchy (TreeID, TreeParentID, Tree)
LOAD
    NodeID as TreeID,
    ParentID as TreeParentID,
    NodeName as Tree
FROM [lib://DataFiles/WineDistricts.qvd] (qvd);
Le modèle complet
Les trois tables jouent chacune un rôle. Toutes ne sont pas nécessaires : ne chargez que celles dont vos analyses ont besoin.
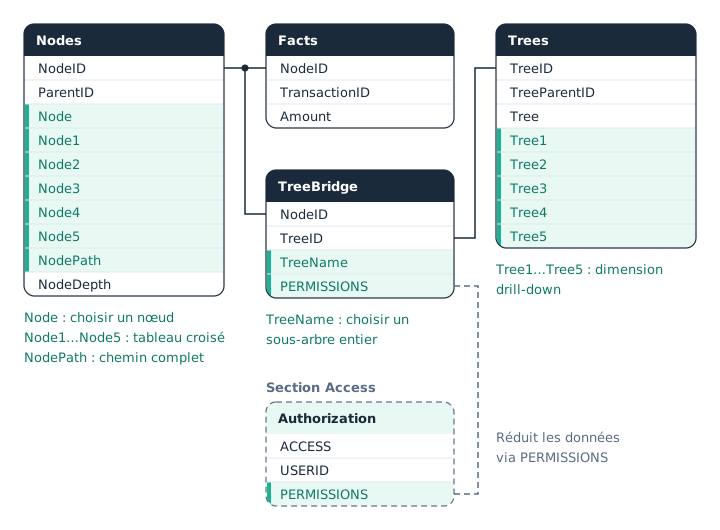
Nodes pour les niveaux, TreeBridge pour les sous-arbres, Trees pour le drill-down.
Des droits d’accès par branche
La hiérarchie sert aussi à sécuriser. Dans un organigramme, un responsable doit voir son département et tous ses sous-départements, mais pas les autres. Le champ TreeName est le bon champ de réduction : autoriser « Product », c’est autoriser tout le sous-arbre Product.
Quand la source est une table d’adjacence, il suffit de dériver une copie en majuscules de TreeName. Les valeurs de réduction de la Section Access doivent en effet être en majuscules.
// TempTreeBridge was loaded with HierarchyBelongsTo
[TreeBridge]:
LOAD *, Upper(TreeName) as PERMISSIONS
RESIDENT [TempTreeBridge];
DROP TABLE [TempTreeBridge];

Section Access;
Authorization:
LOAD
    ACCESS,
    USERID,
    Upper(Permissions) as PERMISSIONS
FROM [lib://DataFiles/Organization.xlsx] (ooxml, embedded labels, table is Access);
Section Application;
En Client-Managed, USERID prend la forme DOMAINE\utilisateur. N’oubliez pas la ligne INTERNAL\SA_SCHEDULER en ADMIN, sans quoi les rechargements planifiés échouent. En SaaS, vérifiez le format d’identifiant attendu par votre tenant. Le Technical Brief évoquait aussi la réduction par QlikView Publisher ; Qlik Sense passe par la Section Access.
Quand la hiérarchie est horizontale, HierarchyBelongsTo ne s’applique pas. On construit alors la table de pont à la main : une boucle sur les champs de niveau suffit.
FOR EACH vLevel IN 'Board level', 'Top level', 'Department', 'Unit'
    Trees:
    LOAD DISTINCT
        DepartmentID,
        Upper([$(vLevel)]) as PERMISSIONS
    RESIDENT [Horizontal Hierarchy];
NEXT vLevel
Chaque département reçoit une ligne par niveau qui le contient : une permission « CEO » ouvre toute la branche du CEO.
Contrôler l’intégrité de la source
Les hiérarchies déséquilibrées souffrent souvent de données incohérentes. Trois défauts méritent un contrôle avant de charger :
- Doublons et parents multiples : un nœud décrit deux fois, ou rattaché à deux parents, multiplie les lignes produites (deux, quatre, huit…) selon le nombre d’ancêtres concernés. L’affichage devient incohérent et les performances se dégradent.
- Parents absents : un
ParentIDsans ligne correspondante, souvent la racine, crée plusieurs racines. Ces racines ne sont pas sélectionnables. - Références circulaires : A a B pour parent, B a C, C a A. La résolution casse la boucle en supprimant un lien, voire exclut des nœuds. Henric Cronström recommande de toujours les éviter.
// Duplicates and multiple parents
CheckNodes:
LOAD
    NodeID,
    Count(NodeID) as NoOfInstances,
    Count(DISTINCT ParentID) as NoOfParents
RESIDENT Source
GROUP BY NodeID;

// Parents that are not listed as nodes
CheckParents:
LOAD
    NodeID,
    If(Exists(NodeID, ParentID), 'Existing', 'Missing') as ParentExistence
RESIDENT Source;
Les racines légitimes, sans parent, sortent aussi en « Missing » : c’est attendu. Pour les cycles, le document propose une boucle qui descend l’arbre niveau par niveau. Elle s’arrête quand plus aucun nœud n’est ajouté, ou quand un nœud réapparaît parmi ses propres ancêtres. Supprimez ces tables de contrôle une fois l’analyse faite.
À retenir
- Identifiez le format source. Horizontale, adjacence, chemins, ensembles imbriqués ou ancêtres : le chargement en dépend.
- Niveaux nommés, drill-down. Une dimension drill-down dans les éléments principaux suffit quand les niveaux sont nommés et fixes.
- Hierarchy pour les niveaux. Le préfixe ajoute un champ par niveau, le chemin et la profondeur, sans changer le nombre de lignes.
- HierarchyBelongsTo pour les sous-arbres. La table des ancêtres permet de sélectionner une branche entière d’un clic.
- Des noms de champs distincts. Nommez le nœud différemment dans chaque table pour éviter les clés synthétiques.
- Une réduction par branche. Le nom de l’ancêtre, en majuscules, devient le champ de réduction de la Section Access.
- Contrôlez la source. Doublons, parents absents et cycles faussent l’arbre : vérifiez-les avant de charger.
Essayer dans Qlik Sense
Ce script reprend les exemples de l’article avec les données des schémas, chargées en INLINE : il ne dépend d’aucun fichier ni d’aucune base. Collez-le dans l’éditeur de chargement de données d’une application vide, choisissez l’exemple avec la variable vExemple, puis rechargez.
// Hiérarchies dans Qlik Sense : script d'essai
// D'après « Hierarchies », Technical Brief d'Henric Cronström (Qlik, 2013), adapté par HeyData.
// Collez-le dans l'éditeur de chargement de données d'une application vide, choisissez
// l'exemple, rechargez, puis ouvrez la visionneuse du modèle de données.
SET vExemple = 1;   // 1 à 3

IF $(vExemple) = 1 THEN
    // Exemple 1 : le modèle complet (quatre schémas de l'article)
    // Table d'adjacence : un nœud par ligne, ParentID vide pour la racine
    Source:
    LOAD NodeID, If(Len(ParentID), ParentID) as ParentID, NodeName
    INLINE [
    NodeID, ParentID, NodeName
    1, , The World
    20, 1, Americas
    79, 20, United States
    85, 79, California
    178, 1, Europe
    281, 178, France
    283, 281, Bordeaux
    288, 283, Médoc
    354, 178, Germany
    ];

    // Nœuds développés : une colonne par niveau
    [Nodes]:
    Hierarchy (NodeID, ParentID, Node, NodeParent, Node, NodePath, '/', NodeDepth)
    LOAD NodeID, ParentID, NodeName as Node
    RESIDENT Source;

    // Table des ancêtres : un couple nœud / ancêtre par ligne
    [TempTreeBridge]:
    HierarchyBelongsTo (NodeID, ParentID, NodeName, TreeID, TreeName)
    NoConcatenate LOAD NodeID, ParentID, NodeName
    RESIDENT Source;

    [TreeBridge]:
    NoConcatenate
    LOAD *, Upper(TreeName) as PERMISSIONS
    RESIDENT [TempTreeBridge];
    DROP TABLE [TempTreeBridge];

    // Arbres : Tree1 à Tree5 pour une dimension drill-down
    [Trees]:
    Hierarchy (TreeID, TreeParentID, Tree)
    LOAD NodeID as TreeID, ParentID as TreeParentID, NodeName as Tree
    RESIDENT Source;

    DROP TABLE Source;

    Facts:
    LOAD * INLINE [
    TransactionID, NodeID, Amount
    T1, 85, 100
    T2, 288, 250
    T3, 283, 40
    T4, 354, 80
    ];

    // Droits par branche, chargés ici comme une table ordinaire.
    // En Section Access, ils réduiraient les données ; ajoutez-la seulement sur une copie,
    // avec une ligne ADMIN pour votre propre compte.
    Authorization:
    LOAD ACCESS, USERID, Upper(Permissions) as PERMISSIONS
    INLINE [
    ACCESS, USERID, Permissions
    USER, ALICE, Europe
    USER, BOB, Americas
    ];
    // TreeName = Europe : 5 nœuds possibles, Sum(Amount) = 370.
    // USERID = ALICE : mêmes données, par PERMISSIONS.
END IF

IF $(vExemple) = 2 THEN
    // Exemple 2 : contrôler l'intégrité d'une source défectueuse
    Source:
    LOAD * INLINE [
    NodeID, ParentID, NodeName
    178, 1, Europe
    281, 178, France
    283, 281, Bordeaux
    283, 178, Bordeaux
    400, 999, Orphan
    ];

    // Doublons et parents multiples
    CheckNodes:
    LOAD
        NodeID,
        Count(NodeID) as NoOfInstances,
        Count(DISTINCT ParentID) as NoOfParents
    RESIDENT Source
    GROUP BY NodeID;

    // Parents absents de la liste des nœuds
    CheckParents:
    LOAD
        NodeID,
        If(Exists(NodeID, ParentID), 'Existing', 'Missing') as ParentExistence
    RESIDENT Source;
    // 283 a deux parents ; 178 (parent 1) et 400 (parent 999) ont un parent absent.
END IF

IF $(vExemple) = 3 THEN
    // Exemple 3 : une hiérarchie horizontale, sans HierarchyBelongsTo
    [Horizontal Hierarchy]:
    LOAD * INLINE [
    DepartmentID, Board level, Top level, Department, Unit
    D1, CEO, Sales, Retail, Shops
    D2, CEO, Sales, Wholesale, Key accounts
    D3, CEO, Operations, Logistics, Warehouse
    ];

    FOR EACH vLevel IN 'Board level', 'Top level', 'Department', 'Unit'
        Trees:
        LOAD DISTINCT
            DepartmentID,
            Upper([$(vLevel)]) as PERMISSIONS
        RESIDENT [Horizontal Hierarchy];
    NEXT vLevel
    // PERMISSIONS = SALES : D1 et D2 ; PERMISSIONS = CEO : les trois départements.
END IF
Source
« Hierarchies », QlikView Technical Brief, Henric Cronström (alias « hic » sur Qlik Community), 26 novembre 2013, publié sur Qlik Community dans la rubrique QlikView Documents. Tout le mérite du contenu original lui revient ; l’adaptation à Qlik Sense et ses éventuelles erreurs sont de HeyData.
Cet article fait partie de notre relecture des Technical Briefs : découvrir la série et les autres documents adaptés à Qlik Sense.