
· Par Équipe HeyData
Série : Les Technical Briefs d’Henric Cronström, relus pour Qlik Sense · article 5 sur 7
IntervalMatch et dimensions à évolution lente dans Qlik Sense
Une vente datée doit retrouver le taux de change, le tarif ou le département valables ce jour-là. En SQL, un BETWEEN suffit. Dans le modèle associatif de Qlik Sense, ce lien se construit au chargement : voici comment le faire avec IntervalMatch, puis comment l’étendre aux dimensions à évolution lente.
Cet article synthétise et adapte à Qlik Sense le Technical Brief « IntervalMatch and Slowly Changing Dimensions » d’Henric Cronström (Qlik, juin 2013). Ses documents techniques restent des références : nous les relisons avec les outils d’aujourd’hui.
Le problème
Prenons deux tables. La première contient des événements datés (EventDate). La seconde contient des intervalles, définis par une borne de début et une borne de fin (IntervalBegin, IntervalEnd). Elles n’ont aucun champ en commun : Qlik ne peut pas les associer.
Dans le cas général, la relation est plusieurs-à-plusieurs. Un intervalle contient plusieurs événements, et un événement peut tomber dans plusieurs intervalles s’ils se chevauchent. Il faut donc une troisième table, une table de pont, qui liste chaque couple événement–intervalle.
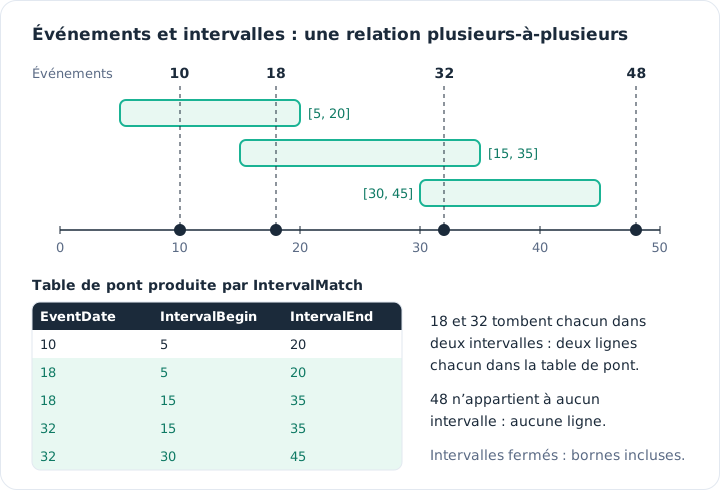
Un événement peut appartenir à zéro, un ou plusieurs intervalles.
Le problème se corse quand une clé s’ajoute. Un vendeur appartient à un département pendant une période donnée, puis change de département. C’est une dimension à évolution lente (slowly changing dimension, SCD) : il faut faire correspondre à la fois le vendeur et la date de la transaction.
IntervalMatch : la table de pont en une instruction
Le préfixe IntervalMatch est la méthode la plus simple. Placé devant un LOAD qui ne contient que les deux bornes, il génère toutes les combinaisons entre ces intervalles et un champ numérique déjà chargé. On charge donc d’abord les événements, puis les intervalles, puis le pont :
Events:
LOAD EventID, EventDate, EventAttribute
FROM [lib://DataFiles/Events.qvd] (qvd);

Intervals:
LOAD IntervalID, IntervalBegin, IntervalEnd, IntervalAttribute
FROM [lib://DataFiles/Intervals.qvd] (qvd);

BridgeTable:
IntervalMatch (EventDate)
LOAD DISTINCT IntervalBegin, IntervalEnd
RESIDENT Intervals;
Tout se passe dans l’éditeur de chargement de données, à l’identique sur Qlik Sense SaaS et Client-Managed ; à notre connaissance, le Data Manager n’offre pas d’équivalent.
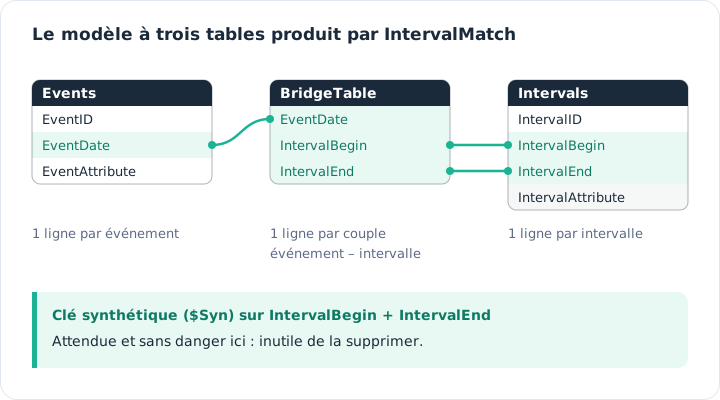
Le modèle normalisé : chaque table garde exactement son nombre de lignes.
Ce modèle est compact et juste : Events et Intervals restent intactes, un Count(EventID) reste exact dans toute visualisation. En revanche, tant que la relation est plusieurs-à-plusieurs, ne joignez pas le pont à l’une des tables d’origine : la jointure multiplierait des lignes et fausserait les agrégations.
La visionneuse du modèle de données affichera une clé synthétique ($Syn) sur IntervalBegin et IntervalEnd. Henric Cronström est catégorique : « This synthetic key should be there ». Elle ne coûte pas de mémoire excessive et n’a pas à être supprimée. On ne retire une clé synthétique que si l’un de ses champs ne devrait pas servir de clé, ou si elle repose sur une autre clé synthétique.
Deux limites, toutefois : le pont ne peut pas porter d’autres champs, et IntervalMatch traite tous les intervalles comme fermés, bornes incluses.
Trois alternatives quand IntervalMatch ne suffit pas
| Méthode | Champs en plus dans le pont | Intervalles gérés | Coût |
|---|---|---|---|
IntervalMatch | non | fermés uniquement | la plus simple, très rapide |
While qui énumère chaque valeur | oui | entiers ou dates seulement | rapide |
Join puis filtre Where | oui | ouverts ou fermés, au choix | très gourmande en mémoire |
While + Peek(), jointure « manuelle » | oui | ouverts ou fermés, au choix | plus lente, mais économe en mémoire |
La jointure complète crée le produit cartésien avant de filtrer : réservez-la aux petits volumes, ou aux cas où une clé supplémentaire limite les combinaisons. La boucle avec Peek() offre la même souplesse sans ce coût mémoire. Ici, l’intervalle est semi-ouvert :
BridgeTable:
LOAD DISTINCT IntervalID, EventDate
WHERE IntervalBegin <= EventDate AND EventDate < IntervalEnd;
LOAD IntervalID, IntervalBegin, IntervalEnd,
    Peek('EventDate', IterNo() - 1, 'Events') as EventDate
RESIDENT Intervals
WHILE IterNo() <= NoOfRows('Events');
Simplifier le modèle, avec prudence
Si vous savez qu’un événement n’appartient qu’à un seul intervalle, le pont devient superflu : la clé de l’intervalle peut aller directement dans la table d’événements. On calcule alors une clé composite, la même des deux côtés, et on joint le pont aux événements :
Intervals:
LOAD *, AutoNumber(Num(IntervalBegin) & '|' & Num(IntervalEnd)) as IntervalKey
FROM [lib://DataFiles/Intervals.qvd] (qvd);

BridgeTable:
IntervalMatch (EventDate)
LOAD DISTINCT IntervalBegin, IntervalEnd
RESIDENT Intervals;

LEFT JOIN (Events)
LOAD EventDate, AutoNumber(Num(IntervalBegin) & '|' & Num(IntervalEnd)) as IntervalKey
RESIDENT BridgeTable;

DROP TABLE BridgeTable;
Num() rend la clé indépendante du format de date, AutoNumber() la remplace par un entier compact. Ce montage supprime aussi la clé synthétique. Mais si un événement tombe en réalité dans deux intervalles, la jointure duplique des lignes : vérifiez le nombre de lignes de Events avant et après.
Joindre le pont à la table d’intervalles est en revanche une fausse bonne idée : les événements étant bien plus nombreux, elle gonflerait sans raison.
Bornes ouvertes, fermées et semi-ouvertes
Quand des intervalles sont contigus, la fin de l’un est le début du suivant : avec des bornes fermées, une valeur tombant pile sur cette limite appartient aux deux. Pour qu’elle n’appartienne qu’à un seul, on retire une infime quantité à la borne de fin. Pour des dates, DayEnd(IntervalEnd - 1) donne la dernière milliseconde de la veille.
On peut aussi soustraire un epsilon. Trop petit, il disparaît dans l’arrondi des nombres flottants (52 bits significatifs). Pour des dates, on peut descendre jusqu’à Pow(2, -37), un peu moins d’une microseconde. Mais en dessous de Pow(2, -27), un peu moins d’une milliseconde, l’écart reste invisible dans les formats date et horodatage, qui arrondissent à la milliseconde. Dual() permet de choisir l’affichage :
LET vEpsilon = Pow(2, -27);

Intervals:
LOAD IntervalID, IntervalBegin,
    Dual(Date(IntervalEnd), IntervalEnd - $(#vEpsilon)) as IntervalEnd
FROM [lib://DataFiles/Intervals.qvd] (qvd);
Le # de $(#vEpsilon) force le point décimal à l’expansion : indispensable dans une app paramétrée avec la virgule comme séparateur.
Quand l’intervalle n’a qu’une date de début
Souvent, la source ne stocke que la date du changement. Un taux de change, par exemple, vaut jusqu’au changement suivant ; une date vide désigne le taux initial. On reconstruit la fin de chaque intervalle en deux passes : on remplace les dates vides par le début de la plage d’étude, puis on trie par devise et date décroissante pour lire la ligne précédente avec Peek().
LET vBeginTime = Num(MakeDate(2013, 1, 1));
LET vEndTime   = Num(Now());
LET vEpsilon   = Pow(2, -27);

Tmp_Rates:
LOAD Currency, Rate,
    Date(If(IsNum([Change Date]), [Change Date], $(#vBeginTime))) as FromDate
FROM [lib://DataFiles/Rates.xlsx] (ooxml, embedded labels, table is Rates);

Rates:
LOAD Currency, Rate, FromDate,
    Date(If(Currency = Peek('Currency'),
            Peek('FromDate') - $(#vEpsilon),
            $(#vEndTime))) as ToDate
RESIDENT Tmp_Rates
ORDER BY Currency, FromDate DESC;

DROP TABLE Tmp_Rates;
MakeDate() évite de dépendre du format de date de l’app, contrairement à une chaîne comme '1/1/2013'.
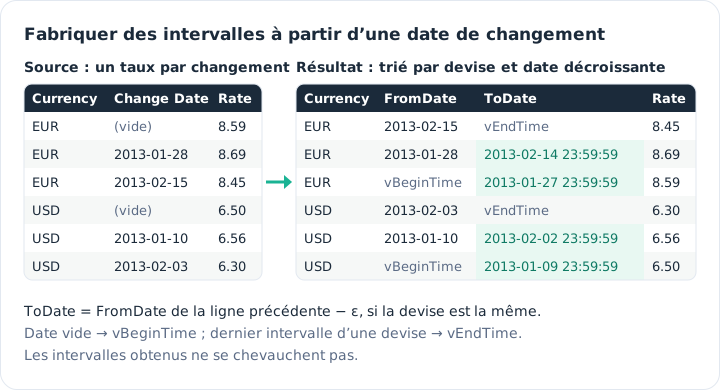
Une date de changement par ligne devient un intervalle sans chevauchement.
Dimensions à évolution lente
Première condition : l’historique doit exister. Si la source écrase l’ancien département, les ventes passées basculent dans le nouveau et aucun script n’y peut rien. En général, elle conserve une ligne par version avec sa date de changement, souvent dans une table dynamique (SalespeopleDyn) distincte des attributs stables (Salespeople). Une fois les intervalles reconstruits comme ci-dessus, la forme étendue d’IntervalMatch accepte des clés supplémentaires :
IntervalMatch (TransactionDate, SPID)
LOAD DISTINCT FromDate, ToDate, SPID
RESIDENT SalespeopleDyn;
Laisser ce pont tel quel ne suffit pas : SPID et les dates relient alors les tables par plusieurs chemins, et le modèle devient faux. Le pont doit être le seul lien entre faits et dimensions, via deux clés composites. Côté transactions, [SPID+TransDate]. Côté dimension, [SPID+Interval]. Et SPID ne doit plus figurer dans la table de faits :
SalespeopleDyn:
LOAD *, SPID & '|' & FromDate & '|' & ToDate as [SPID+Interval]
FROM [lib://DataFiles/SalespeopleDyn.qvd] (qvd);

Transactions:
LOAD TransactionID, TransactionDate, ProductID, Amount,
    SPID as TmpSPID,
    SPID & '|' & TransactionDate as [SPID+TransDate]
FROM [lib://DataFiles/Transactions.qvd] (qvd);

Tmp_BridgeTable:
IntervalMatch (TransactionDate, TmpSPID)
LOAD DISTINCT FromDate, ToDate, SPID as TmpSPID
RESIDENT SalespeopleDyn;

BridgeTable:
LOAD TmpSPID & '|' & TransactionDate as [SPID+TransDate],
    TmpSPID & '|' & FromDate & '|' & ToDate as [SPID+Interval]
RESIDENT Tmp_BridgeTable;

DROP FIELD TmpSPID;
DROP TABLE Tmp_BridgeTable;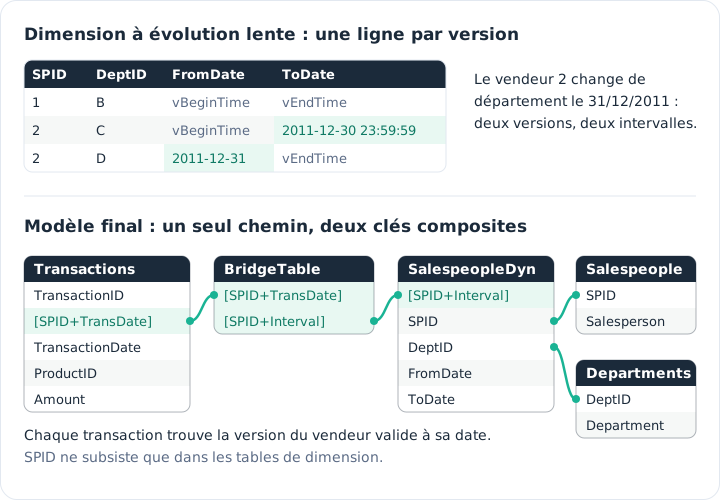
Chaque transaction retrouve la version du vendeur valable à sa date.
Dans la plupart des cas, un vendeur n’appartient qu’à un département à la fois : la relation est plusieurs-à-un. On peut alors joindre le pont à la table de faits avec LEFT JOIN (Transactions) sur TmpSPID et TransactionDate ; la clé [SPID+TransDate] devient inutile. Henric Cronström prévient toutefois qu’il a vu plus d’une fois cette certitude démentie par les données : contrôlez le nombre de lignes avant de joindre. Variante sans IntervalMatch : énumérer les dates de chaque intervalle par une boucle While dans une table de correspondance, puis poser [SPID+Interval] avec ApplyMap() au chargement des transactions.
Plusieurs tables d’intervalles
Quand plusieurs tables d’intervalles se croisent, la technique clé est le partitionnement : découper des intervalles qui se chevauchent en sous-intervalles élémentaires : chaque événement n’appartient plus qu’à un seul d’entre eux. On réunit tous les débuts et fins dans un même champ, puis on les retransforme en intervalles par la méthode de la date unique, vendeur par vendeur.
Premier cas : des incidents et des équipes de travail, bornés dans le temps et rattachés à une machine. Quelle équipe a géré quel incident ? Un découpage à la minute fonctionnerait, au prix d’un gros volume et d’arrondis ; mieux vaut relier les deux tables à une table commune de sous-intervalles. Second cas, la SCD à deux niveaux : le vendeur change de département, le département change d’unité. On joint les deux tables dynamiques sur le département, on garde les périodes qui se chevauchent, bornées par RangeMax() des débuts et RangeMin() des fins, puis on les rattache aux transactions comme une SCD simple.
À retenir
- IntervalMatch d’abord. Trois tables, une clé synthétique assumée : c’est le modèle le plus simple et le plus juste pour une relation plusieurs-à-plusieurs.
- La clé synthétique n’est pas un défaut. Celle d’IntervalMatch est inoffensive ; supprimez-la seulement si le modèle l’exige.
- Joindre, c’est parier. Ne joignez le pont aux faits que si la relation est vraiment plusieurs-à-un, et vérifiez le nombre de lignes.
- Soignez les bornes. Intervalles contigus : retirez un epsilon ou utilisez
DayEnd()pour qu’une valeur limite n’appartienne qu’à un intervalle. - Une date de changement suffit.
Peek()sur une table triée en ordre décroissant reconstruit la fin de chaque intervalle. - Pour une SCD, un seul chemin. Deux clés composites et
SPIDretiré des faits : chaque transaction retrouve la bonne version de la dimension.
Essayer dans Qlik Sense
Ce script reprend les exemples de l’article avec les données des schémas, chargées en INLINE : il ne dépend d’aucun fichier ni d’aucune base. Collez-le dans l’éditeur de chargement de données d’une application vide, choisissez l’exemple avec la variable vExemple, puis rechargez.
// IntervalMatch et dimensions à évolution lente : script d'essai
// D'après « IntervalMatch and Slowly Changing Dimensions », Technical Brief d'Henric Cronström (Qlik, 2013), adapté par HeyData.
// Collez-le dans l'éditeur de chargement de données d'une application vide, choisissez
// l'exemple, rechargez, puis ouvrez la visionneuse du modèle de données.
SET vExemple = 1;   // 1 à 5

IF $(vExemple) <= 3 THEN
    // Exemples 1 à 3 : quatre événements et trois intervalles fermés (premier schéma)
    Events:
    LOAD * INLINE [
    EventID, EventDate, EventAttribute
    E1, 10, a
    E2, 18, b
    E3, 32, c
    E4, 48, d
    ];

    Intervals:
    LOAD * INLINE [
    IntervalID, IntervalBegin, IntervalEnd, IntervalAttribute
    I1, 5, 20, x
    I2, 15, 35, y
    I3, 30, 45, z
    ];
END IF

IF $(vExemple) = 1 THEN
    // Exemple 1 : IntervalMatch crée la table de pont (deuxième schéma)
    BridgeTable:
    IntervalMatch (EventDate)
    LOAD DISTINCT IntervalBegin, IntervalEnd
    RESIDENT Intervals;
    // 5 lignes : 18 et 32 deux fois, 48 jamais. La clé synthétique est attendue.
END IF

IF $(vExemple) = 2 THEN
    // Exemple 2 : la même table de pont par une boucle While, bornes semi-ouvertes
    BridgeTable:
    LOAD DISTINCT IntervalID, EventDate
    WHERE IntervalBegin <= EventDate AND EventDate < IntervalEnd;
    LOAD IntervalID, IntervalBegin, IntervalEnd,
        Peek('EventDate', IterNo() - 1, 'Events') as EventDate
    RESIDENT Intervals
    WHILE IterNo() <= NoOfRows('Events');
    // Pas de clé synthétique : le pont ne porte que IntervalID et EventDate.
END IF

IF $(vExemple) = 3 THEN
    // Exemple 3 : le pont joint aux événements, avec une clé d'intervalle compacte
    RENAME TABLE Intervals TO TmpIntervals;
    Intervals:
    NOCONCATENATE
    LOAD *, AutoNumber(Num(IntervalBegin) & '|' & Num(IntervalEnd)) as IntervalKey
    RESIDENT TmpIntervals;
    DROP TABLE TmpIntervals;

    BridgeTable:
    IntervalMatch (EventDate)
    LOAD DISTINCT IntervalBegin, IntervalEnd
    RESIDENT Intervals;

    LEFT JOIN (Events)
    LOAD EventDate, AutoNumber(Num(IntervalBegin) & '|' & Num(IntervalEnd)) as IntervalKey
    RESIDENT BridgeTable;

    DROP TABLE BridgeTable;
    // Events passe de 4 à 6 lignes : 18 et 32 sont dupliqués. Vérifiez toujours ce nombre.
END IF

IF $(vExemple) = 4 THEN
    // Exemple 4 : des intervalles fabriqués à partir d'une date de changement (troisième schéma)
    LET vBeginTime = Num(MakeDate(2013, 1, 1));
    LET vEndTime   = Num(Now());
    LET vEpsilon   = Pow(2, -27);

    Tmp_Rates:
    LOAD Currency, Rate,
        Date(If(IsNum(Date#([Change Date], 'YYYY-MM-DD')),
                Date#([Change Date], 'YYYY-MM-DD'),
                $(#vBeginTime))) as FromDate
    INLINE [
    Currency, Change Date, Rate
    EUR, , 8.59
    EUR, 2013-01-28, 8.69
    EUR, 2013-02-15, 8.45
    USD, , 6.50
    USD, 2013-01-10, 6.56
    USD, 2013-02-03, 6.30
    ];

    Rates:
    LOAD Currency, Rate, FromDate,
        Timestamp(If(Currency = Peek('Currency'),
                     Peek('FromDate') - $(#vEpsilon),
                     $(#vEndTime))) as ToDate
    RESIDENT Tmp_Rates
    ORDER BY Currency, FromDate DESC;

    DROP TABLE Tmp_Rates;
    // EUR 8.69 : du 2013-01-28 au 2013-02-14 23:59:59 ; les intervalles ne se chevauchent pas.
END IF

IF $(vExemple) = 5 THEN
    // Exemple 5 : une dimension à évolution lente (quatrième schéma)
    LET vBeginTime = Num(MakeDate(2010, 1, 1));
    LET vEndTime   = Num(Now());

    Salespeople:
    LOAD * INLINE [
    SPID, Salesperson
    1, Alice
    2, Bruno
    ];

    Departments:
    LOAD * INLINE [
    DeptID, Department
    B, Retail
    C, Wholesale
    D, Export
    ];

    SalespeopleDyn:
    LOAD *, SPID & '|' & FromDate & '|' & ToDate as [SPID+Interval];
    LOAD SPID, DeptID,
        Timestamp(If(Len(From), Date#(From, 'YYYY-MM-DD'), $(#vBeginTime))) as FromDate,
        Timestamp(If(Len(To), DayEnd(Date#(To, 'YYYY-MM-DD')), $(#vEndTime))) as ToDate
    INLINE [
    SPID, DeptID, From, To
    1, B, ,
    2, C, , 2011-12-30
    2, D, 2011-12-31,
    ];

    Transactions:
    LOAD TransactionID, TransactionDate, ProductID, Amount,
        SPID as TmpSPID,
        SPID & '|' & TransactionDate as [SPID+TransDate];
    LOAD TransactionID, Date(Date#(TransactionDate, 'YYYY-MM-DD')) as TransactionDate,
        ProductID, Amount, SPID
    INLINE [
    TransactionID, TransactionDate, SPID, ProductID, Amount
    T1, 2011-06-15, 2, P1, 300
    T2, 2012-02-10, 2, P2, 450
    T3, 2011-09-01, 1, P1, 120
    ];

    Tmp_BridgeTable:
    IntervalMatch (TransactionDate, TmpSPID)
    LOAD DISTINCT FromDate, ToDate, SPID as TmpSPID
    RESIDENT SalespeopleDyn;

    BridgeTable:
    LOAD TmpSPID & '|' & TransactionDate as [SPID+TransDate],
        TmpSPID & '|' & FromDate & '|' & ToDate as [SPID+Interval]
    RESIDENT Tmp_BridgeTable;

    DROP FIELD TmpSPID;
    DROP TABLE Tmp_BridgeTable;
    // T1 (2011) est rattachée au département C, T2 (2012) au département D.
END IF
Source
« IntervalMatch and Slowly Changing Dimensions », Henric Cronström (alias « hic » sur Qlik Community), QlikView Technical Brief, 3 juin 2013, publié sur Qlik Community dans la rubrique QlikView Documents. Tout le mérite du contenu original lui revient ; l’adaptation à Qlik Sense et ses éventuelles erreurs sont de HeyData.
Cet article fait partie d’une série consacrée aux Technical Briefs Qlik. Découvrir la série permet de retrouver les autres documents relus.