
Brouillon : cet article n'est pas publié. Il n'apparaît pas dans le blog et n'est pas indexé.
· Par Équipe HeyData
Série : Concevoir des jobs Talend : les bonnes pratiques de Dale Anderson, relues pour la version 8 de Talend Studio · article 6 sur 7
Les performances d’un job Talend : mémoire, lookups et parallélisme
Un job qui traite mille lignes en développement peut s’effondrer devant dix millions en production. Le plus souvent, le code n’y est pour rien : c’est la mémoire qui manque, un lookup chargé en entier, ou un parallélisme qui sature le serveur. La performance d’un job Talend se joue moins dans les expressions que dans quelques réglages qu’on oublie de faire.
Cet article synthétise et adapte à Talend Studio 8 les parties 2, 3 et 4 de « Talend Job Design Patterns and Best Practices » de Dale Anderson (Talend, 2016). Ses conseils restent des références : nous les relisons avec les outils d’aujourd’hui.
La mémoire : un réglage à faire, pas à subir
Un job Talend est un programme Java : il tourne dans une JVM dont la mémoire est bornée par l’argument -Xmx. Les valeurs par défaut conviennent à un essai, rarement à un traitement réel. Dale Anderson énumère les questions à se poser : combien de lignes et de colonnes, combien de lookups dans les tMap, combien de jobs enfants et dans quelle JVM, combien d’autres jobs tournent en même temps sur le serveur, avec combien de cœurs et de mémoire ?
La mémoire se règle à deux niveaux :
- pour tous les jobs, dans Window › Preferences › Talend › Run/Debug ;
- pour un job, dans la vue Run, onglet Advanced settings, case Use specific JVM arguments.
-Xms1024M
-Xmx4096M
Par défaut, Studio lance les jobs avec -Xms256M et -Xmx1024M. Un -Xmx plus grand n’est pas une solution universelle : la mémoire du serveur est partagée entre les jobs qui tournent en même temps. Le réglage se décide avec l’exploitation et s’écrit dans le guide de développement.
Les lookups du tMap : mémoire ou vitesse
Le tMap joint le flux principal à des lookups. Par défaut, chaque lookup est lu en entier et gardé en mémoire avant le passage de la première ligne. C’est rapide, mais un lookup de plusieurs millions de lignes, ou plusieurs lookups de cette taille, peuvent épuiser la mémoire. Le tMap propose trois modes de chargement :
- Load once lit tout le lookup une fois, en mémoire : le plus rapide, le plus gourmand ;
- Reload at each row relit le lookup pour chaque ligne du flux principal, avec la clé de cette ligne : très peu de mémoire, mais une requête par ligne ;
- Reload at each row (cache) fait de même, mais garde les lignes déjà lues : une requête par clé nouvelle.
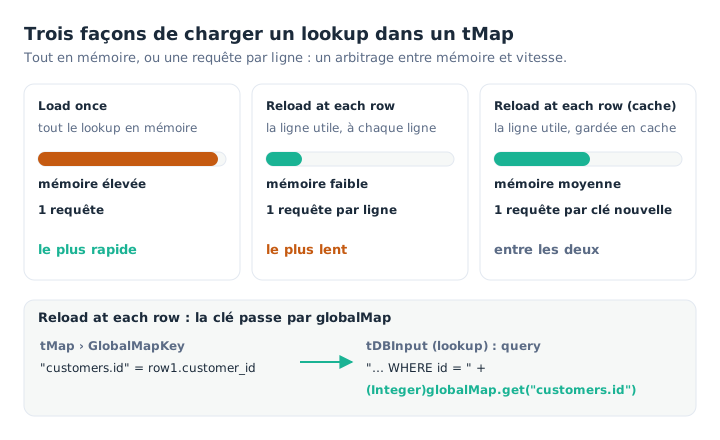
Load once tient tout en mémoire ; Reload at each row interroge la base ligne à ligne, avec la clé passée par globalMap.
Le mode Reload at each row demande une astuce. Dans le tMap, Studio ajoute au lookup un champ GlobalMapKey, par exemple "customers.id", que l’on alimente avec la clé du flux principal, row1.customer_id. La requête du composant de lookup la relit dans globalMap, dans sa clause WHERE :
"SELECT id, segment FROM customers WHERE id = " + (Integer)globalMap.get("customers.id")Ce mode n’a d’intérêt que si le flux principal est petit devant le lookup : une requête par ligne sur un flux de dix millions de lignes serait bien plus lente qu’un chargement unique.
Un troisième recours existe quand le lookup doit rester en Load once mais dépasse la mémoire : l’option Store temp data du lookup, dans le tMap, écrit ses données sur disque plutôt qu’en mémoire. Le dossier (Temp data directory path) et la taille du tampon en mémoire (Max buffer size, 2 000 000 de lignes par défaut) se règlent dans les propriétés du tMap. Cette option ne se combine pas avec le mode Reload at each row (cache).
Le parallélisme, à doser
Talend offre plusieurs façons d’exécuter des traitements en même temps. Elles vont du plus large au plus fin, et peuvent se combiner :
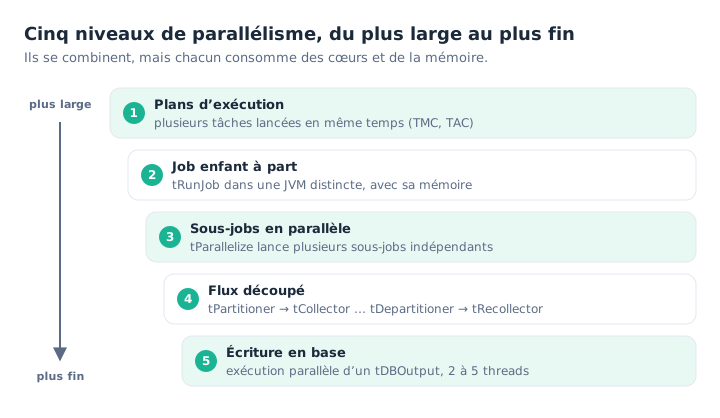
Chaque niveau multiplie les cœurs et la mémoire consommés : on les additionne avant de les empiler.
- les plans d’exécution de l’ordonnanceur lancent plusieurs tâches en parallèle ;
- un
tRunJobavec Use an independent process to run subjob lance l’enfant dans une JVM distincte. Ce n’est pas du parallélisme en soi, mais cela isole sa mémoire ; tParallelizedémarre plusieurs sous-jobs indépendants en même temps, puis attend leur fin pour continuer ;tPartitioner,tCollector,tDepartitionerettRecollectordécoupent un flux en plusieurs threads, puis le reconstituent. La documentation conseille aujourd’hui de laisser Studio les poser lui-même : clic droit sur le composant de départ, Set parallelization ;- les composants de sortie en base proposent, dans leurs réglages avancés, une exécution parallèle de l’écriture. Dale Anderson conseille 2 à 5 threads : au-delà, la base sature et l’effet s’inverse.
Il déconseillait en revanche de poser plusieurs flux sans lien dans un même job pour les faire tourner ensemble : mieux vaut des jobs séparés. Et il insistait sur la règle qui vaut pour tous ces niveaux : connaître la consommation de mémoire et de cœurs de chaque job avant d’en lancer plusieurs.
Les itérations : ligne à ligne, quand il le faut
Un lien Row transporte un jeu de données entier, traité d’un bloc par le sous-job. Certains traitements doivent au contraire se répéter pour chaque ligne : lire un fichier par nom trouvé, appeler un job enfant par client. C’est le rôle des liens Iterate.
tFlowToIterate transforme chaque ligne d’un flux en une itération, et range ses colonnes dans globalMap. tIterateToFlow fait l’inverse : il reconstitue un flux à partir d’itérations. Dale Anderson met en garde : une fois le flux découpé en itérations, il faut souvent le reconstituer avant certains composants, comme le tMap, qui n’acceptent qu’un flux.
Les itérations ont un coût : chaque tour relance le sous-job qui suit. Itérer sur dix fichiers est naturel ; itérer sur un million de lignes pour faire ce qu’un flux ferait d’un bloc est une erreur fréquente. Le lien Iterate propose lui aussi une exécution parallèle, à manier avec la même prudence.
Ce qui a changé depuis 2016
- Sur Qlik Talend Cloud, les arguments de la JVM d’un job lancé sur un Remote Engine se règlent dans un profil d’exécution (run profile) de Talend Management Console, qui l’emporte sur les valeurs de Studio. Les plans de Talend Management Console enchaînent des tâches, en série ou en parallèle.
tParallelizeest réservé aux offres par abonnement ;tPartitioneret ses compagnons, aux offres Platform et Big Data.
À retenir
- La mémoire se règle.
-Xmxpar job ou pour tout le projet, en accord avec l’exploitation. - Load once par défaut. Rapide, tant que le lookup tient en mémoire.
- Reload at each row pour un gros lookup. La clé passe par
globalMapdans la clauseWHERE. - Store temp data en dernier recours. Le lookup sur disque plutôt qu’en mémoire.
- Un parallélisme dosé. Plusieurs niveaux possibles, 2 à 5 threads pour écrire en base.
- Des itérations raisonnables. Pour des fichiers ou des appels, pas pour remplacer un flux.
Essayer dans Talend Studio
Pour voir la mémoire d’un lookup en action :
- Créez un job avec deux
tRowGenerator: le premier produit 1 000 lignes (idde 1 à 1 000 avecNumeric.sequence("s1", 1, 1)), le second 2 000 000 de lignes avec unid(Numeric.sequence("s2", 1, 1)) et un libellé de 50 caractères (TalendString.getAsciiRandomString(50)). - Reliez le premier comme flux principal d’un
tMap, le second comme lookup, avec une jointure surid, puis untLogRowen sortie. - Dans la vue Run, Advanced settings, cochez Use specific JVM arguments et mettez
-Xmx256M. Exécutez : le job échoue faute de mémoire (OutOfMemoryError). - Dans le tMap, activez Store temp data sur le lookup ; dans les propriétés du tMap, indiquez un dossier temporaire et ramenez Max buffer size à 100 000 lignes. Relancez : le job passe, plus lentement.
- Désactivez Store temp data et passez à
-Xmx2048M: le job passe, plus vite.
Sources
- Dale Anderson, Talend Job Design Patterns and Best Practices, partie 2, partie 3 et partie 4, Talend (version archivée).
- Aide Qlik Talend : mémoire de la JVM, limites de mémoire du tMap, modèles de lookup, parallélisation des flux, itérations parallèles et tFlowToIterate.
Tout le mérite du contenu original revient à Dale Anderson ; l’adaptation à Talend Studio 8 et ses éventuelles erreurs sont de HeyData. Cet article fait partie de notre série sur les bonnes pratiques de conception de jobs Talend : découvrir la série.