
Brouillon : cet article n'est pas publié. Il n'apparaît pas dans le blog et n'est pas indexé.
· Par Équipe HeyData
Série : Concevoir des jobs Talend : les bonnes pratiques de Dale Anderson, relues pour la version 8 de Talend Studio · article 5 sur 7
Schémas et SQL dynamiques dans Talend : métadonnées, Dynamic et CDC
Un job Talend décrit ses données par un schéma : la liste des colonnes, leur type, leur longueur. Recopié composant par composant, ce schéma devient vite un piège : une colonne ajoutée à une table, et il faut retoucher dix jobs. Talend offre plusieurs moyens de décrire les données une seule fois, voire de ne pas les décrire du tout et de les découvrir à l’exécution.
Cet article synthétise et adapte à Talend Studio 8 les parties 2, 3 et 4 de « Talend Job Design Patterns and Best Practices » de Dale Anderson (Talend, 2016). Ses conseils restent des références : nous les relisons avec les outils d’aujourd’hui.
Des schémas définis une fois, dans le référentiel
La section Metadata du référentiel rassemble les descriptions réutilisables : connexions aux bases et schémas de leurs tables, formats de fichiers (délimité, positionnel, XML, JSON, Excel…), services web, annuaires LDAP. Un composant qui s’y rattache reprend le schéma du référentiel ; si celui-ci change, Studio propose de propager la modification aux jobs qui l’utilisent.
Parmi ces métadonnées, Dale Anderson met en avant les schémas génériques. Ils ne sont liés à aucune source : on les taille pour un besoin. Deux cas reviennent souvent :
- enrichir : la table
accountsa 12 colonnes, le flux du job en porte 16, dont 4 calculées. Un schéma générique de 16 colonnes décrit ce flux ; - réduire : une table de 100 colonnes dont le job n’utilise que 10. Le schéma générique ne garde que celles-là, et la requête aussi.
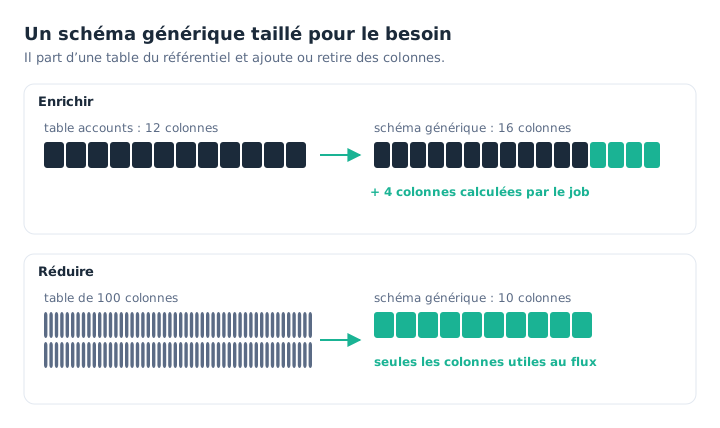
Le schéma générique décrit le flux du job, pas forcément la table.
Son conseil : des schémas génériques partout, sauf peut-être pour une structure d’une seule colonne, plus simple à déclarer dans le composant. Et un nom explicite : par défaut, Studio nomme chaque schéma « metadata », d’où la convention md_ vue dans le premier article.
Une requête construite à l’exécution
Le champ Query d’un tDBInput accepte une expression Java, pas seulement un texte figé. On peut donc assembler la requête à partir de variables de contexte, renseignées plus tôt dans le job, par exemple dans un tJava :
"SELECT " + context.sqlCOLUMNS + " FROM " + context.sqlFROM + " WHERE " + context.sqlWHERECe n’est pas du SQL dynamique au sens de la base, mais une requête générée par le job. Deux précautions. La première : prévoir les espaces entre les morceaux, sinon les mots se collent. La seconde : ne jamais concaténer une valeur saisie par un utilisateur ou lue dans un fichier externe, qui ouvrirait la porte à l’injection SQL. Pour une simple valeur de filtre, une requête préparée (Use PreparedStatement dans les réglages avancés du tDBRow) est plus sûre.
Les schémas dynamiques
Copier cent tables d’une base à une autre avec un job par table n’a pas de sens. Le schéma dynamique résout ce cas : une colonne de type Dynamic porte, à l’exécution, toutes les colonnes de la source, quelles qu’elles soient. Le job ne les connaît pas à l’avance.
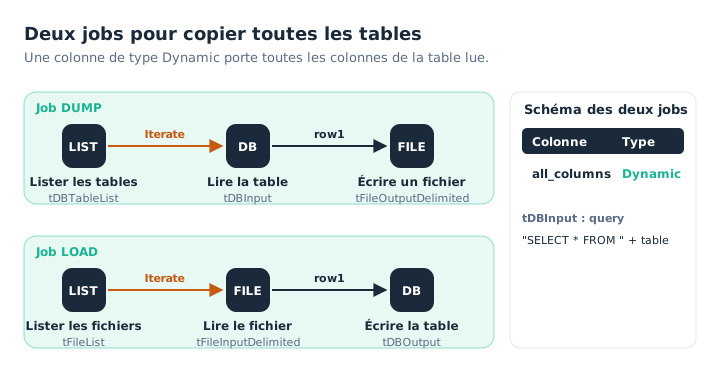
Un job vide les tables dans des fichiers, l’autre les recharge ; aucun ne connaît les colonnes.
Dale Anderson décrit ce modèle en deux jobs. Le premier liste les tables, puis, pour chacune, lit ses lignes dans une colonne Dynamic et les écrit dans un fichier. Le second fait l’inverse. Il construisait lui-même la liste des tables et des colonnes en interrogeant les tables système de la base (INFORMATION_SCHEMA), puis la passait au composant tSetDynamicSchema, indispensable pour écrire un fichier positionnel. Les composants t<Base>TableList et t<Base>ColumnList, par exemple tMysqlTableList, font le même travail sans connaître ces tables système.
Avec une colonne Dynamic, la requête d’un tDBInput doit contenir SELECT * : c’est la base qui fournit la liste des colonnes. Le schéma doit aussi être déclaré dans le composant (Built-In), pas repris du référentiel.
Les autres composants SQL
Toutes les requêtes ne lisent pas des lignes. Trois composants complètent la palette :
tDBRowexécute une requête qui ne renvoie pas de résultat :TRUNCATE,CREATE INDEX,DROP TABLE;tDBSPappelle une procédure stockée ;tMysqlLastInsertId, et ses équivalents pour d’autres bases, relisent l’identifiant généré par la dernière insertion.
Le CDC : ne lire que ce qui a changé
Recharger une table entière chaque nuit coûte cher quand quelques lignes seulement ont bougé. Le CDC (Change Data Capture) capte les insertions, mises à jour et suppressions dans la source, pour que le job ne lise que les changements depuis son dernier passage.
Dans Studio, le CDC repose sur un modèle de publication et d’abonnement. Le mode par défaut utilise des déclencheurs posés sur les tables sources, qui notent les changements dans des tables de suivi ; les composants t<Base>CDC, comme tMysqlCDC ou tOracleCDC, les lisent ensuite. Pour Oracle, Studio propose aussi le mode XStream, et le mode par journaux de redo et d’archive cité par Dale Anderson. La mise en place est lourde : droits sur la base source, tables de suivi, abonnés. Elle se décide en amont et se documente dans le guide de développement.
Ce qui a changé depuis 2016
- Les schémas dynamiques et le CDC étaient réservés aux éditions commerciales ; depuis la fin de Talend Open Studio, le 31 janvier 2024, ce sont les seules.
- Studio propose des composants de base de données génériques (
tDBInput,tDBOutput,tDBRow,tDBSP,tDBTableList) qui se règlent pour une base donnée. Les composants propres à chaque base existent toujours. - Le mode CDC par journaux de redo et d’archive est déprécié pour Oracle, comme Oracle 11 ; XStream reste disponible pour Oracle 12 et suivants.
À retenir
- Des schémas dans le référentiel. Décrits une fois, propagés aux jobs qui les utilisent.
- Des schémas génériques partout. Taillés pour le flux : enrichis ou réduits.
- Des requêtes assemblées avec soin. Des espaces entre les morceaux, aucune valeur externe concaténée.
- Dynamic pour l’inconnu. Une colonne porte toutes les colonnes, avec un
SELECT *. - Les bons composants SQL.
tDBRow,tDBSP,LastInsertIdpour ce qui ne lit pas de lignes. - Le CDC se prépare. Une architecture à concevoir et documenter avant le premier job.
Essayer dans Talend Studio
Pour voir une colonne Dynamic absorber un changement de structure :
- Créez un fichier
clients.csvavec un en-tête et deux lignes :id;nompuis1;Dupontet2;Martin. - Créez un job avec un
tFileInputDelimited: séparateur;, Header à 1, et un schéma d’une seule colonneall_columnsde type Dynamic. - Reliez-le à un
tLogRow, puis exécutez : les deux colonnes s’affichent. - Ajoutez une colonne
villeau fichier (id;nom;ville,1;Dupont;Lyon,2;Martin;Nantes) et relancez, sans toucher au job : la troisième colonne apparaît.
Sources
- Dale Anderson, Talend Job Design Patterns and Best Practices, partie 2, partie 3 et partie 4, Talend (version archivée).
- Aide Qlik Talend : Generic schemas, Dynamic schema, tSetDynamicSchema, composants de base génériques et Change Data Capture.
Tout le mérite du contenu original revient à Dale Anderson ; l’adaptation à Talend Studio 8 et ses éventuelles erreurs sont de HeyData. Cet article fait partie de notre série sur les bonnes pratiques de conception de jobs Talend : découvrir la série.